ডেটা দিয়ে গল্প বলা: চার্ট বানানো নয়, পয়েন্ট বোঝানোই আসল কাজ
এই লেখাটি মূলত Claus O. Wilke-র Fundamentals of Data Visualization বইয়ের ২৯ নম্বর অধ্যায় “Telling a story and making a point”-এর আলোচনার ভিত্তিতে লেখা, সঙ্গে যুক্ত হয়েছে Cole Nussbaumer Knaflic-এর কাজ এবং সাম্প্রতিক গবেষণা থেকে পাওয়া কিছু সংযোজন।
ভূমিকা: গল্প আপনি না বললে, দর্শক নিজেই বানিয়ে নেবেন
বেশিরভাগ ডেটা ভিজ্যুয়ালাইজেশন করা হয় যোগাযোগের জন্য। আমাদের হাতে একটা ডেটাসেট আছে, সেখান থেকে একটা অন্তর্দৃষ্টি (insight) পেয়েছি, আর আছে একদল দর্শক - যাদের কাছে সেই অন্তর্দৃষ্টিটা পৌঁছে দিতে চাই।
বিজ্ঞানী, প্রকৌশলী বা অ্যানালিস্টদের অনেকেই “গল্প” শব্দটা শুনে অস্বস্তিতে পড়েন। মনে হয়, গল্প মানেই তো বানিয়ে বলা, স্পিন দেওয়া, ফলাফলকে বাড়িয়ে দেখানো। এই ভাবনাটা একটা গুরুত্বপূর্ণ জিনিস মিস করে যায়: মানুষের যুক্তিবোধ আর স্মৃতি গল্পের কাঠামোতেই কাজ করে।
আর সবচেয়ে গুরুত্বপূর্ণ কথাটি হলো - যেকোনো যোগাযোগই দর্শকের মাথায় একটা গল্প তৈরি করে। আপনি যদি নিজে স্পষ্ট গল্প না দেন, দর্শক নিজেই একটা বানিয়ে নেবেন। ভাগ্য ভালো হলে সেটা আপনার বক্তব্যের কাছাকাছি হবে। কিন্তু প্রায়ই সেই বানানো গল্পটা হয়:
- “এটা তো বিরক্তিকর”
- “লেখক ভুল বলছেন”
- “লেখক বিষয়টা বোঝেনই না”
অর্থাৎ, গল্প বলা বা না-বলা আপনার হাতে নেই। কোন গল্পটা বলবেন, সেটাই কেবল আপনার হাতে।
সত্যি ঘটনাও দুর্দান্ত গল্প হতে পারে
Wilke একটা উদাহরণ দেন। তাত্ত্বিক পদার্থবিদ স্টিফেন হকিং-এর ২১ বছর বয়সে - পিএইচডির প্রথম বছরে - মোটর নিউরন ডিজিজ ধরা পড়ে; ডাক্তাররা বলেছিলেন দুই বছর বাঁচবেন। হকিং সেটা মেনে নেননি, বরং সমস্ত শক্তি ঢেলে দিয়েছিলেন বিজ্ঞানে। শেষ পর্যন্ত তিনি ৭৬ বছর বেঁচেছেন, নিজের সময়ের অন্যতম প্রভাবশালী পদার্থবিদ হয়েছেন, এবং তাঁর যুগান্তকারী কাজগুলো করেছেন মারাত্মক শারীরিক প্রতিবন্ধকতার মধ্যেই।
এটা একটা টানটান গল্প। এবং এর প্রতিটি বাক্য তথ্যনির্ভর ও সত্য। এখানে কোনো স্পিন নেই।
১. গল্প আসলে কী?
গল্প হলো - পর্যবেক্ষণ, তথ্য বা ঘটনার একটা সেট, যেগুলো এমন একটা নির্দিষ্ট ক্রমে সাজানো যে দর্শকের মধ্যে একটা আবেগিক প্রতিক্রিয়া তৈরি হয়।
এই প্রতিক্রিয়া তৈরি হয় টেনশন (tension) → রেজলিউশন (resolution) পথ ধরে। শুরুতে উত্তেজনা বা প্রশ্ন তৈরি হয়, শেষে তার নিষ্পত্তি। এই প্রবাহকেই বলে স্টোরি আর্ক (story arc)। প্রতিটি ভালো গল্পের একটা স্পষ্ট, চেনা যায় এমন আর্ক থাকে।
কয়েকটি প্রচলিত গল্পের কাঠামো
| কাঠামো | কীভাবে কাজ করে | কখন ব্যবহার করবেন |
|---|---|---|
| Opening – Challenge – Action – Resolution | ধীরে ধীরে গড়ে ওঠে, সবচেয়ে বেশি নাটকীয় টান | প্রেজেন্টেশন, দীর্ঘ ব্লগ, গবেষণাপত্রের ন্যারেটিভ |
| Lead – Development (– Resolution) | মূল বক্তব্য শুরুতেই বলে দেওয়া, পরে বিস্তারিত | সংবাদ প্রতিবেদন, এক্সিকিউটিভ সামারি, সোশ্যাল মিডিয়া পোস্ট |
| Action – Background – Development – Climax – Ending | মাঝপথ থেকে শুরু, তাড়াতাড়ি আবেগিক সংযোগ, কিন্তু ফলাফল শেষে | ফিচার লেখা, কীনোট টক |
হকিং-এর গল্পটাই যদি Lead–Development ফরম্যাটে বলতে হতো, শুরুটা হতো এভাবে: “যে পদার্থবিদ ব্ল্যাক হোল ও কসমোলজি সম্পর্কে আমাদের ধারণা বদলে দিয়েছিলেন, তিনি ডাক্তারদের পূর্বাভাসের চেয়ে ৫৩ বছর বেশি বেঁচেছিলেন - এবং তাঁর সবচেয়ে প্রভাবশালী কাজগুলো করেছিলেন গুরুতর প্রতিবন্ধী অবস্থায়।” তারপর বিস্তারিত।
একটা মাত্র ফিগারে পুরো গল্প খুব কমই আঁটে
এটাই সবচেয়ে বেশি উপেক্ষিত পয়েন্ট। একটা স্ট্যাটিক ফিগার সাধারণত গল্পের যেকোনো একটা অংশ দেখাতে পারে - ওপেনিং, চ্যালেঞ্জ, অ্যাকশন বা রেজলিউশন - সবগুলো একসঙ্গে নয়।
তাই পুরো গল্প বলতে সাধারণত একাধিক ফিগার লাগে। টকে হয়তো প্রথমে প্রেক্ষাপট, তারপর একটা ফিগার যা প্রশ্ন তোলে, তারপর আরেকটা যা উত্তর দেয়। ব্যতিক্রম আছে - একটা ফিগারেই চ্যালেঞ্জ ও রেজলিউশন দুটোই রাখা সম্ভব, কিন্তু সেটা Lead দিয়ে শুরু করা গল্পের মতো কাজ করে।
২. কেস স্টাডি: দুটি ফিগারে একটি গল্প
Wilke-র নিজের উদাহরণটা চমৎকার - জীববিজ্ঞানে প্রিপ্রিন্টের বৃদ্ধি।
প্রেক্ষাপট: প্রিপ্রিন্ট হলো পিয়ার রিভিউ ও আনুষ্ঠানিক প্রকাশনার আগেই সহকর্মীদের সঙ্গে ভাগ করে নেওয়া গবেষণাপত্রের খসড়া। ১৯৯০-এর দশকের শুরুতে ইন্টারনেট আসার পর পদার্থবিদরা বুঝলেন, খসড়াগুলো একটা কেন্দ্রীয় ভাণ্ডারে রাখাই বেশি কার্যকর। তাঁরা তৈরি করলেন প্রিপ্রিন্ট সার্ভার - arXiv.org। পরে সেটা গণিত, জ্যোতির্বিজ্ঞান, কম্পিউটার সায়েন্স, পরিসংখ্যান, কোয়ান্টিটেটিভ বায়োলজি (q-bio) ইত্যাদিতেও ছড়িয়ে পড়ে।
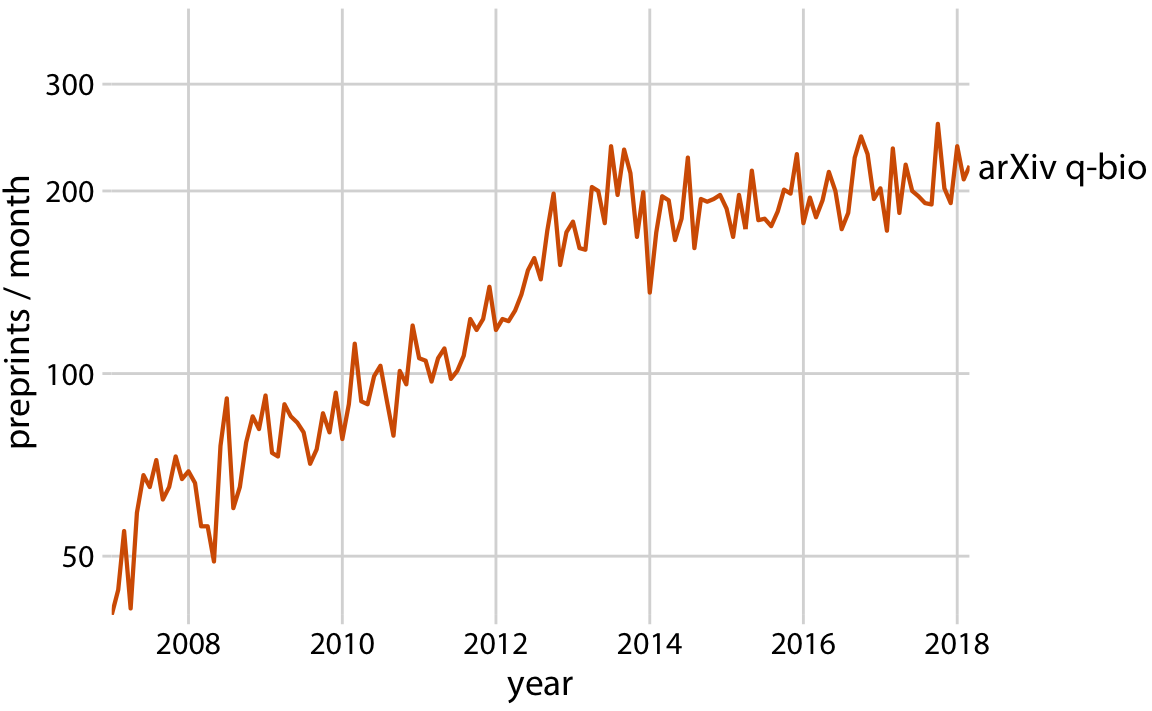
ফিগার ১ → চ্যালেঞ্জ। arXiv-এর q-bio সেকশনে মাসিক সাবমিশন ২০০৭ থেকে ২০১৩-র শেষ পর্যন্ত এক্সপোনেনশিয়ালি বাড়ছিল (লগ স্কেলে সরলরেখা)। তারপর হঠাৎ বৃদ্ধি থেমে গেল - ২০১৪ থেকে ২০১৮ পর্যন্ত প্রায় সমতল।
প্রশ্ন তৈরি হলো: ২০১৩-র শেষে এমন কী ঘটেছিল যা প্রিপ্রিন্টের চিত্র আমূল বদলে দিল?
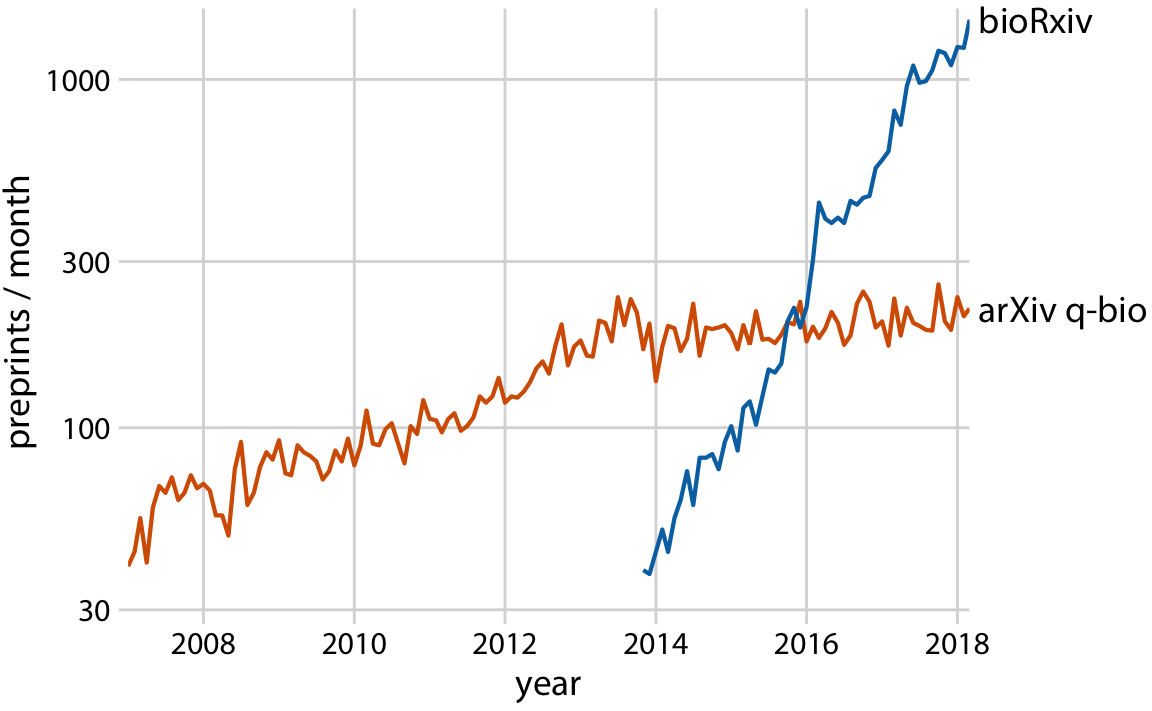
ফিগার ২ → রেজলিউশন। ২০১৩ সালের নভেম্বরে Cold Spring Harbor Laboratory Press চালু করে জীববিজ্ঞান-নির্দিষ্ট প্রিপ্রিন্ট সার্ভার bioRxiv। জীববিজ্ঞানীদের কাছে CSHL Press-এর বিশ্বাসযোগ্যতা প্রিপ্রিন্ট গ্রহণযোগ্যতাকে অনেকটা এগিয়ে দেয়। যাঁরা arXiv নিয়ে সন্দিহান ছিলেন, তাঁরাই bioRxiv-এ স্বচ্ছন্দ বোধ করলেন। দ্বিতীয় ফিগারে q-bio ও bioRxiv দুটোর বৃদ্ধি পাশাপাশি দেখালে দেখা যায় - q-bio-র বৃদ্ধি থেমে যাওয়ার সময়টা ঠিক bioRxiv-এর এক্সপোনেনশিয়াল বৃদ্ধি শুরুর সময়ের সঙ্গে মিলে যায়।
এখানে শেখার মতো সূক্ষ্ম জিনিসটা কী?
ফিগার ১-এর পুরো তথ্য আসলে ফিগার ২-এর ভেতরেই আছে। তবু Wilke দুটো আলাদা ফিগার ব্যবহার করেন - কারণ ভেঙে দেখালে গল্পের আঘাতটা বেশি জোরালো হয়। টকে তিনি এভাবেই দেখাবেন।
তবে মাধ্যম বদলালে সিদ্ধান্তও বদলায়: সোশ্যাল মিডিয়া পোস্টের মতো যেখানে দর্শকের মনোযোগের সময় কম, সেখানে শুধু ফিগার ২-ই পুরো গল্প বলার জন্য ভালো।
নীতি: ফিগারের সংখ্যা ডেটা ঠিক করে না, মাধ্যম ও দর্শক ঠিক করে।
৩. “জেনারেলদের জন্য ফিগার বানান”
এই বইয়ের সব উপদেশ মেনেও আপনি এমন ফিগার বানাতে পারেন যা মানুষকে বিভ্রান্ত করে। কারণ দুটো সাধারণ ভুল ধারণা:
- দর্শক ফিগারটা দেখলেই আমার বক্তব্য বুঝে ফেলবেন।
- দর্শক জটিল ভিজ্যুয়াল দ্রুত প্রসেস করে মূল ট্রেন্ড ধরে ফেলতে পারবেন।
দুটোই ভুল।
Wilke বেশ কয়েক বছর মার্কিন সেনাবাহিনীর অর্থায়নে একটা বড় গবেষণা প্রকল্প পরিচালনা করেছেন। বার্ষিক প্রগ্রেস রিপোর্টের জন্য প্রোগ্রাম ম্যানেজাররা তাঁকে বলতেন - বেশি ফিগার দেবেন না, আর যেটা দেবেন সেটা দেখেই একজন জেনারেল যেন তৎক্ষণাৎ বুঝতে পারেন কাজটা আগের সক্ষমতার চেয়ে কতটা ভালো। কিন্তু সহকর্মীদের পাঠানো ফিগারগুলো প্রায়ই ছিল অতিরিক্ত জটিল, দুর্বোধ্য টেকনিক্যাল লেবেলে ভরা, অথবা কোনো স্পষ্ট পয়েন্টই বানাত না।
“জেনারেলরা” কারা?
এখানে ভুল উপসংহার হবে - “জেনারেলরা বিজ্ঞান বোঝেন না।” আসল কথা হলো, তাঁরা ভয়ানক ব্যস্ত। একটা রহস্যময় গ্রাফ ডিকোড করতে ৩০ মিনিট খরচ করার সময় তাঁদের নেই।
আর “জেনারেল” এখানে একটা রূপক। আপনার জেনারেল হতে পারেন:
- আপনার পেপার বা গ্রান্ট প্রপোজালের রিভিউয়ার
- সংবাদপত্রের এডিটর
- আপনার সুপারভাইজার - বা সুপারভাইজারের বস
- ক্লায়েন্টের সিএফও
সরলতাই সবচেয়ে বড় দক্ষতা
আধুনিক টুল এখানে বিপদ ডেকে আনে। ggplot2, Plotly, Tableau, D3 - সবই এত শক্তিশালী যে আরও একটা ডাইমেনশন যোগ করার লোভ সামলানো কঠিন। ফলাফল দেখতে চমৎকার, কিন্তু গল্প বলে না।
Wilke-র উদাহরণ: ২০১৩ সালে নিউ ইয়র্ক থেকে ছাড়া সব ফ্লাইটের অ্যারাইভাল ডিলে - একটা স্ক্যাটারপ্লটে দূরত্ব বনাম গড় বিলম্ব, প্রতিটি পয়েন্ট এক গন্তব্য, পয়েন্টের আকার = ফ্লাইট সংখ্যা, প্রতিটি এয়ারলাইনের জন্য আলাদা ট্রেন্ড লাইন। এই ফিগার পড়তে সময় লাগে, আর বেশিরভাগ পাঠক ধরতেই পারেন না কী দেখানো হচ্ছে।
মূল বক্তব্য যদি হয় “American ও Delta-র বিলম্ব সবচেয়ে কম” - তাহলে একটা সাধারণ বার চার্টই যথেষ্ট। আর পরের প্রশ্ন যদি হয় “ওরা কি কম ফ্লাইট চালায় বলেই কম বিলম্ব?” - তাহলে দ্বিতীয় বার চার্টে দেখান ওরা আসলে বড় ক্যারিয়ার।
দুটো বার চার্টেই “দূরত্ব” ভেরিয়েবলটা বাদ পড়েছে। এবং সেটাই ঠিক। গল্পের সঙ্গে সম্পর্কহীন ডাইমেনশন দেখানোর দরকার নেই - ডেটা থাকলেও নয়, দেখাতে পারলেও নয়।
মনে রাখুন: একসঙ্গে অনেক কিছু দেখাতে গিয়ে শেষে কিছুই দেখানো হয় না।
কখনো ধরে নেবেন না যে দর্শক জটিল ভিজ্যুয়াল দ্রুত প্রসেস করতে পারেন।
৪. জটিলতার দিকে ধাপে ধাপে যান
কখনো কখনো সত্যিই একটা তথ্যবহুল, জটিল ফিগার দরকার হয়। তখন কৌশল হলো - আগে একটা সরল সংস্করণ দেখান, তারপর পূর্ণ সংস্করণ।
প্রেজেন্টেশনে এটা প্রায় বাধ্যতামূলক। সরাসরি জটিল ফিগারে ঝাঁপ দেবেন না।
small multiples বা গ্রিড-প্লটের ক্ষেত্রে এটা সবচেয়ে প্রাসঙ্গিক। উদাহরণ:
-
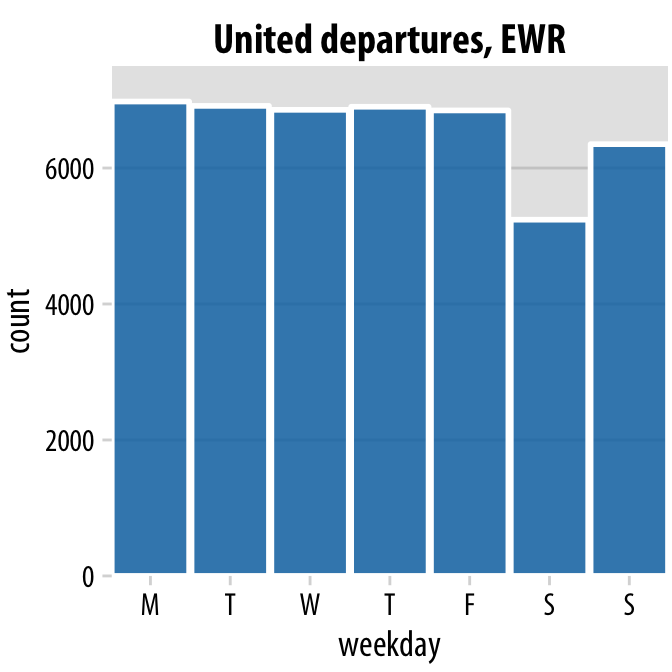
প্রথমে: নিউয়ার্ক এয়ারপোর্ট (EWR) থেকে United Airlines-এর ২০১৩ সালের ডিপার্চার, সপ্তাহের দিন অনুযায়ী - একটাই ছোট প্যানেল। পাঠক দেখে নিলেন: কর্মদিবসগুলোতে প্রায় সমান, সপ্তাহান্তে কম।
-
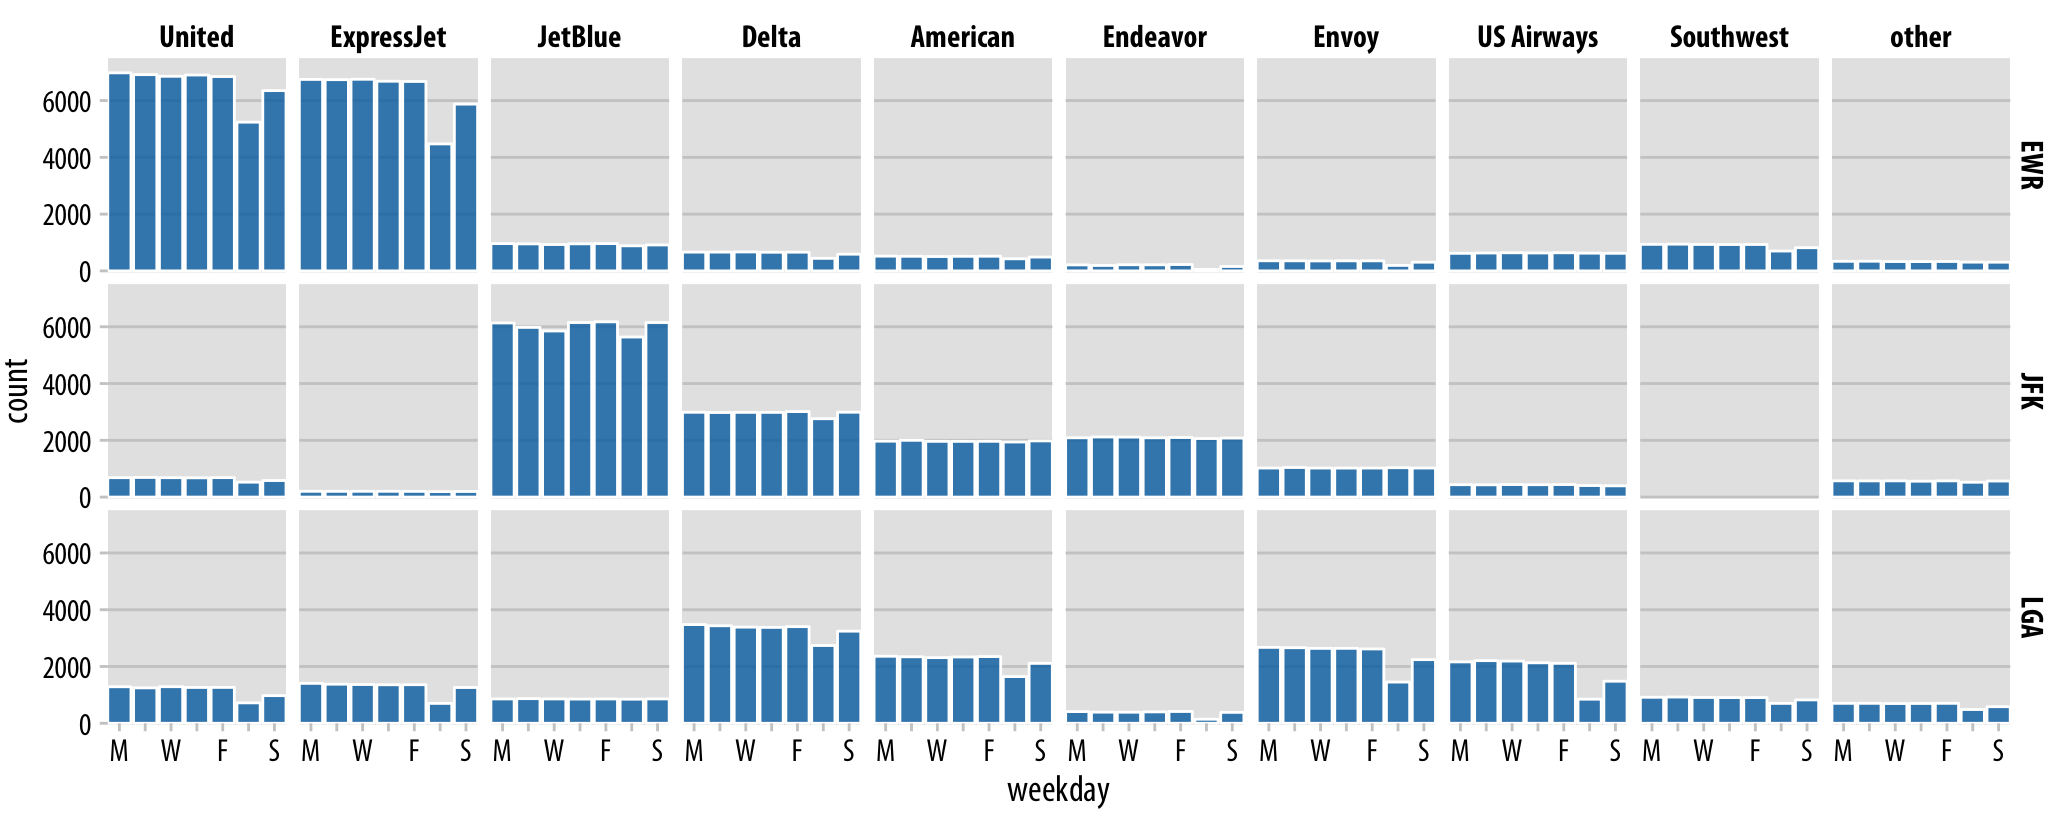
তারপর: সেই একই কাঠামো ১০টি এয়ারলাইন × ৩টি এয়ারপোর্টের গ্রিডে। এখন পাঠকের চোখ জানে কোথায় তাকাতে হবে, তাই ৩০টি প্যানেলও হজম হয়।
৫. ফিগার স্মরণযোগ্য করুন - কিন্তু বিভ্রান্তিকর নয়
সরল, পরিচ্ছন্ন বার চার্টের সুবিধা স্পষ্ট: মনোযোগ বিচ্ছিন্ন হয় না, পড়া সহজ। কিন্তু একটা অসুবিধাও আছে - সেগুলো জেনেরিক দেখতে হয়। পরপর দশটা বার চার্ট দেখালে আপনি কোনটা কী ছিল মনে রাখতে পারবেন না।
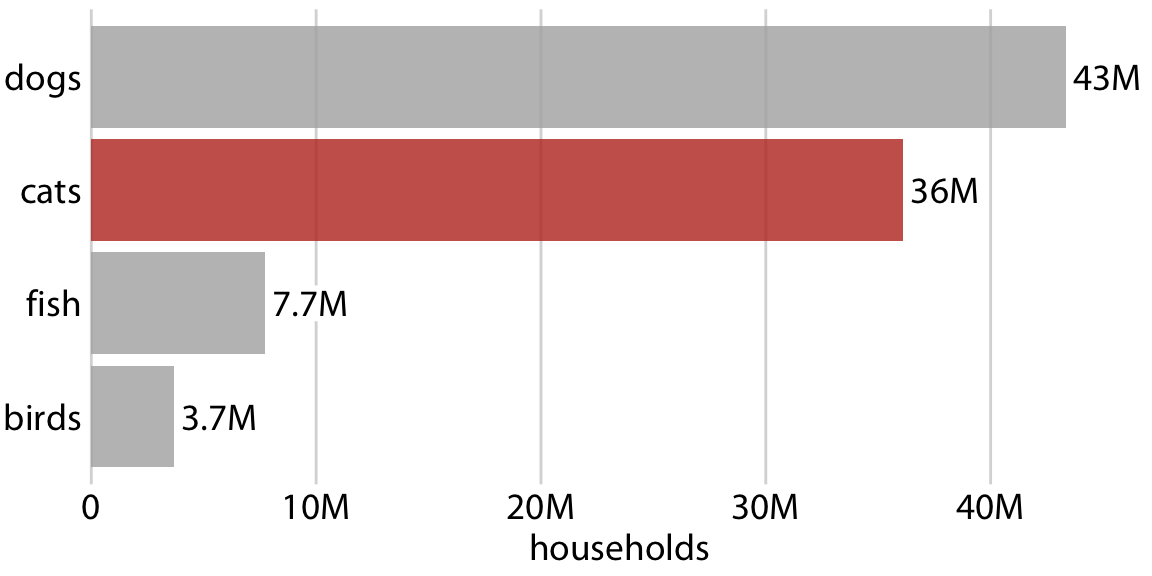
Wilke এর একটা মজার প্রদর্শন করেন: যুক্তরাষ্ট্রে সবচেয়ে জনপ্রিয় পোষা প্রাণীর (কুকুর, বিড়াল, মাছ, পাখি) পরিবার-সংখ্যার বার চার্ট দেখতে হুবহু নিউ ইয়র্ক ফ্লাইট-সংখ্যার বার চার্টের মতো। দুটোর মধ্যে মিল কেবল একটাই - দুটোই বার চার্ট। কোনো ফিগারেই এমন কিছু নেই যা দেখেই বোঝা যায় বিষয়টা কী।
গবেষণা কী বলে
মানব-উপলব্ধি নিয়ে গবেষণা বলে, ভিজ্যুয়ালি বেশি জটিল ও অনন্য ফিগার বেশি মনে থাকে (Bateman et al. 2010; Borgo et al. 2012)। কিন্তু এই অনন্যতা ও জটিলতা দ্রুত ওভারভিউ নেওয়া কঠিন করে দিতে পারে, ছোট পার্থক্য ধরাও কঠিন হয়।
দুই প্রান্তেই বিপদ:
- চরম স্মরণযোগ্য কিন্তু দুর্বোধ্য → শিল্প হিসেবে চমৎকার, ডেটা ভিজ্যুয়ালাইজেশন হিসেবে ব্যর্থ।
- চরম স্পষ্ট কিন্তু নীরস → কেউ মনে রাখে না, প্রভাবও পড়ে না।
লক্ষ্য মাঝামাঝি ভারসাম্য। এবং দর্শকভেদে ভারসাম্যের বিন্দু বদলায় - টেকনিক্যাল জার্নালের জন্য স্মরণযোগ্যতা নিয়ে কম ভাবলে চলে, সংবাদপত্র বা ব্লগের জন্য অনেক বেশি ভাবতে হয়।
সমাধান: আইসোটাইপ প্লট
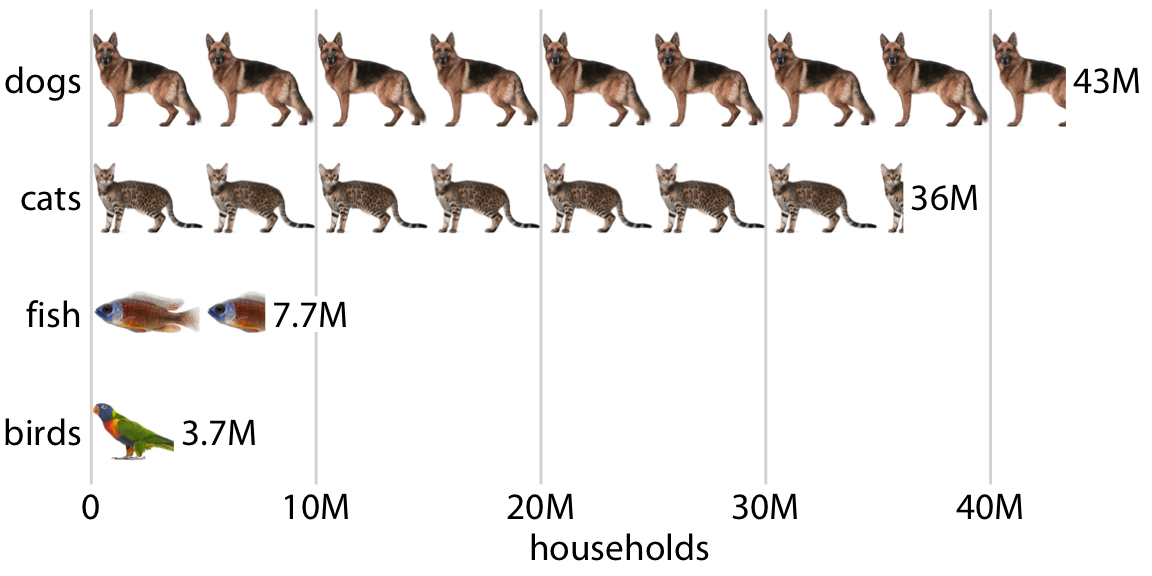 ডেটা যা নিয়ে, সেই জিনিসের ছবি বা পিক্টোগ্রাম ব্যবহার করুন - এবং সেই ছবিগুলো দিয়েই মান প্রকাশ করুন।
পোষা প্রাণীর উদাহরণে বারগুলো বদলে দিন কুকুর, বিড়াল, মাছ ও পাখির পুনরাবৃত্ত ছবি দিয়ে - যেখানে একটি পূর্ণ প্রাণী = ৫০ লাখ পরিবার। ভিজ্যুয়ালি এটা এখনো বার প্লট হিসেবেই কাজ করে, কিন্তু এখন এক ঝলক দেখেই মনে থেকে যায়: কুকুর-বিড়াল অনেক বেশি, মাছ-পাখি অনেক কম।
গুরুত্বপূর্ণ শর্ত: ছবি দিয়ে ডেটা উপস্থাপন করুন, ফিগারকে সাজানোর জন্য বা অক্ষে লেবেল হিসেবে ছবি বসাবেন না। মনস্তাত্ত্বিক পরীক্ষায় দেখা গেছে, শোভাবর্ধক ছবি সাহায্য করার বদলে মনোযোগ বিক্ষিপ্ত করে (Haroz, Kosara & Franconeri 2015)।
শব্দটির উৎস: ISOTYPE = International System Of TYpographic Picture Education। কড়াভাবে এটি লোগো-সদৃশ সরলীকৃত পিক্টোগ্রাম বোঝায়, তবে ব্যাপক অর্থে যেকোনো ভিজ্যুয়ালাইজেশনে একই ছবির পুনরাবৃত্তি দিয়ে মান বোঝানোকেই আইসোটাইপ প্লট বলা যায়।
৬. সামঞ্জস্যপূর্ণ হোন, কিন্তু পুনরাবৃত্তিমূলক নয়
একই গল্পের অংশ হিসেবে বানানো তিনটি ফিগার দেখে যেন বোঝা যায় ওরা একই পরিবারের - একই ফন্ট, একই রঙের স্কিম, একই ভিজ্যুয়াল ভাষা।
কিন্তু সামঞ্জস্য মানে সবকিছু একরকম দেখানো নয় - বরং উল্টোটা।
আলাদা আলাদা বিশ্লেষণ যেন দেখতে আলাদা হয়, যাতে দর্শক বুঝতে পারেন কোথায় এক বিশ্লেষণ শেষ হয়ে আরেকটা শুরু হলো। বার প্লট ব্যবহার করে ফেললে পরেরটায় স্ক্যাটারপ্লট, বক্সপ্লট বা লাইন প্লট নিন। নইলে সব বিশ্লেষণ দর্শকের মাথায় গুলিয়ে যাবে।
নিয়ম: প্রেজেন্টেশন বা রিপোর্ট তৈরির সময় প্রতিটি স্বতন্ত্র বিশ্লেষণের জন্য আলাদা ধরনের ভিজ্যুয়ালাইজেশন বেছে নিন।
উদাহরণ: ফেসবুক স্টক
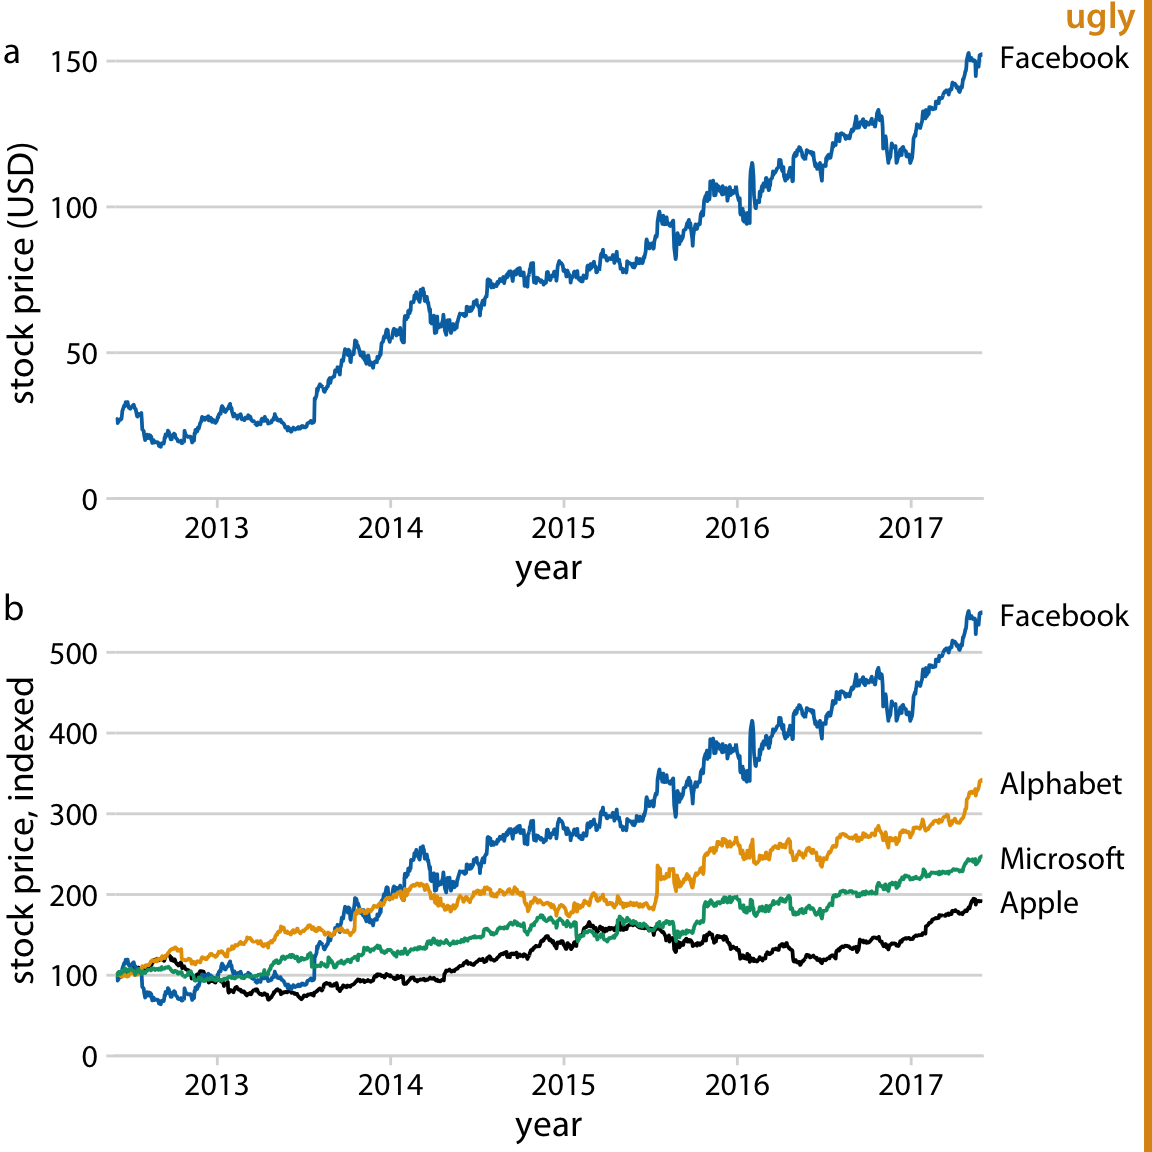 দুই অংশের গল্প: (ক) ২০১২ থেকে ২০১৭-তে ফেসবুকের শেয়ারদর দ্রুত বেড়েছে; (খ) এই বৃদ্ধি অন্যান্য বড় টেক কোম্পানির চেয়ে বেশি।
স্বাভাবিক প্রবণতা: দুটোই টাইম সিরিজ লাইন প্লট হিসেবে দেখানো। ফলাফল - পুনরাবৃত্তিমূলক, আর দ্বিতীয়টা মূল পয়েন্টকেই ঢেকে দেয়। Alphabet, Apple, Microsoft-এর দরের সময়ভিত্তিক ওঠানামার সূক্ষ্মতা আমাদের দরকার নেই; আমরা শুধু বলতে চাই ওদের বৃদ্ধি কম ছিল।
ভালো সমাধান:
- (ক) থাকুক টাইম সিরিজ - কাঁচা দরের গতিপথ (≈$২৫ → ≈$১৫০ প্রতি শেয়ার)।
- (খ) হোক বার প্লট - শতকরা বৃদ্ধি (ফেসবুক প্রায় ৪৫০%, বাকিরা ৯০%–২৪০%)।
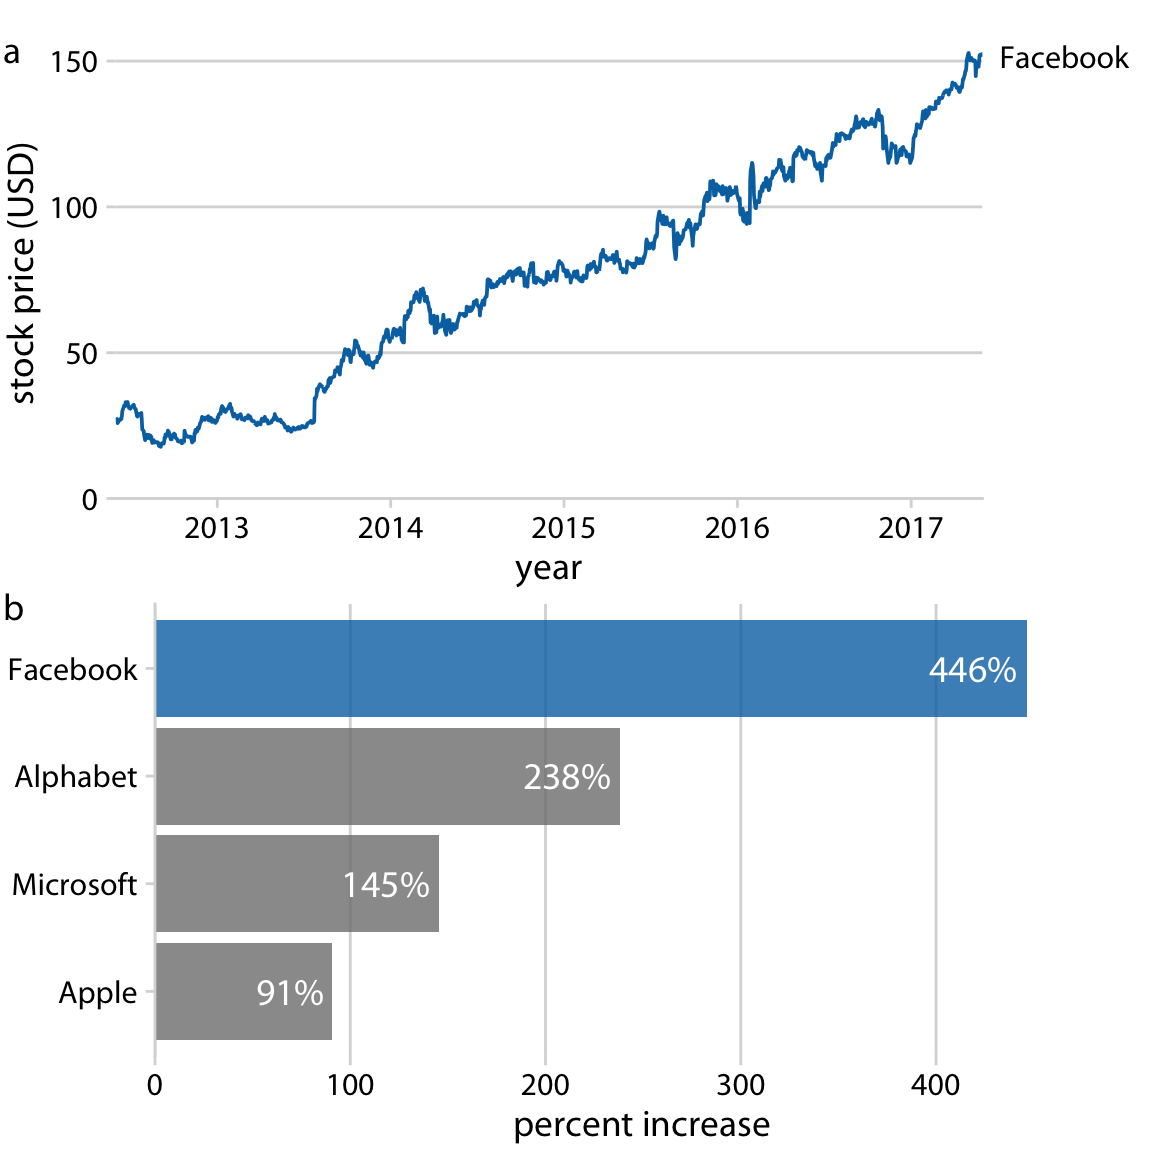 এখন দুটো ফিগার আলাদা, প্রত্যেকটি একটি স্বতন্ত্র পয়েন্ট বানায়, এবং একসঙ্গে ভালো কাজ করে।
৭. কাঁচা ডেটা → derived পরিমাণ: এই ক্রমটাই ঠিক
উপরের উদাহরণটা একটা সাধারণ নীতি দেখায়:
প্রথম ফিগারটা যতটা সম্ভব কাঁচা ডেটার কাছাকাছি রাখুন। পরের ফিগারগুলোতে ক্রমশ বেশি derived পরিমাণ দেখান।
Derived পরিমাণ মানে - শতকরা পরিবর্তন, গড়, অনুপাত, ফিটেড মডেলের কোয়েফিশিয়েন্ট, ইনডেক্স, স্ট্যান্ডার্ডাইজড স্কোর ইত্যাদি। এগুলো বড় ও জটিল ডেটাসেটের মূল প্রবণতা সংক্ষেপে বলার জন্য দারুণ, কিন্তু এরা স্বজ্ঞাত নয়। কাঁচা ডেটা না দেখিয়ে সরাসরি derived পরিমাণ দেখালে দর্শক হারিয়ে যান।
আবার উল্টোটাও সত্যি: সব প্রবণতা কেবল কাঁচা ডেটা দিয়ে দেখাতে গেলে অসংখ্য ফিগার লাগবে এবং সব একঘেয়ে হয়ে যাবে।
৮. কয়টা ফিগার ব্যবহার করবেন?
উত্তরটা মাধ্যমের উপর নির্ভর করে:
| মাধ্যম | ফিগার সংখ্যা |
|---|---|
| টুইট / সোশ্যাল পোস্ট / ছোট ব্লগ | ১টি |
| গবেষণাপত্র | ৩–৬টি (বাকিগুলো অ্যাপেন্ডিক্স বা সাপ্লিমেন্টারিতে) |
| এক ঘণ্টার সেমিনার | সাধারণত ৩টি আলাদা গল্প, প্রতিটির জন্য ৩–৬টি ফিগার |
| বই / থিসিস | প্রতি অধ্যায় বা সেকশনে একটি করে গল্প, প্রতিটিতে ৩–৬টি ফিগার |
সব প্রমাণ নথিভুক্ত করা ভালো - কিন্তু প্রায় একইরকম দেখতে অজস্র ফিগার দিয়ে দর্শককে ক্লান্ত করা যাবে না।
৯. মূল অধ্যায়ের বাইরে: আরও কিছু কার্যকর সংযোজন
Wilke-র অধ্যায়টি ফিগার-কেন্দ্রিক। ব্যবহারিক যোগাযোগের জন্য আরও কয়েকটা স্তর যোগ করা যায়।
৯.১ চার্ট খোলার আগেই দর্শক ও “ask” ঠিক করুন
Cole Nussbaumer Knaflic-এর Storytelling with Data বইয়ের সবচেয়ে ব্যবহারিক পরামর্শ: শুরুতেই ঠিক করুন দর্শক কে, আপনাকে তাঁরা কীভাবে দেখেন, আপনি চান তাঁরা কী জানুন বা করুন, এবং ডেটা কীভাবে সেটাকে সমর্থন করবে।
তাঁর একটা কড়া পরীক্ষা আছে: এক বাক্যে আপনার call to action লিখতে না পারলে, আদৌ যোগাযোগটা করার দরকার আছে কি না ভেবে দেখুন। সঙ্গে “three-minute story” অনুশীলন - মাত্র তিন মিনিট পেলে আপনি কী বলতেন?
আরেকটি গুরুত্বপূর্ণ নীতি: স্পষ্টতার দায় ১০০% যোগাযোগকারীর, শ্রোতার নয়। কেউ আপনার গ্রাফ না বুঝলে সেটা “অজ্ঞ দর্শক” নয়, ব্যর্থ অনুবাদ। দ্রুত পরীক্ষা: স্লাইডটা সামনে রেখে চোখ বন্ধ করুন, খুলুন, আর লক্ষ্য করুন প্রথম দুই সেকেন্ডে চোখ কোথায় পড়ে। (সূত্র)
৯.২ Gestalt নীতি ও pre-attentive অ্যাট্রিবিউট
“সরল করুন” পরামর্শটা যান্ত্রিকভাবে প্রয়োগ করার দুটো টুল:
- Gestalt নীতি - proximity, similarity, enclosure, closure, continuity, connection। এগুলো দিয়ে ঠিক করা যায় কোনটা signal আর কোনটা noise, এবং অপ্রয়োজনীয় বর্ডার-গ্রিডলাইন কোথায় বাদ দেওয়া যায়।
- Pre-attentive অ্যাট্রিবিউট - রঙ, আকার, অবস্থান, ঘনত্ব। সচেতন প্রসেসিং শুরু হওয়ার আগেই এগুলো চোখ টেনে নেয়। একটি বার আলাদা রঙে করা মানে হলো দর্শক কোথায় তাকাবেন সেটা আপনি ঠিক করে দিলেন।
৯.৩ অ্যানোটেশন - সবচেয়ে সস্তা ও অবমূল্যায়িত টুল
Wilke ক্যাপশনে গুরুত্ব দেন, কিন্তু চার্টের ভেতরের টেক্সট অ্যানোটেশন নিয়ে আরও জোর দেওয়া যায়। গবেষণা-পর্যালোচনা বলছে, টেক্সট অ্যানোটেশন মূল বৈশিষ্ট্য চিহ্নিত করে, উপসংহার নির্দেশ করে ও প্রেক্ষাপট দেয় - ফলে বোধগম্যতা ও সম্পৃক্ততা দুটোই বাড়ে (অ্যানোটেশন ট্যাক্সোনমি সার্ভে, arXiv:2306.06043; অ্যানোটেশন সার্ভে, arXiv:2410.05579)।
বাস্তবে এর মানে:
- চার্টের শিরোনামে উপসংহার লিখুন, বিষয় নয় → “২০২৩ সালে ধরে রাখার হার ১২% কমেছে”, “মাসভিত্তিক রিটেনশন” নয়।
- গ্রাফের গায়ে সরাসরি তীর ও ছোট নোট বসান - “এখানেই নতুন প্রাইসিং চালু হয়”।
- লেজেন্ডের বদলে যেখানে সম্ভব সরাসরি লাইনের পাশে লেবেল দিন।
৯.৪ ন্যারেটিভ ভিজ্যুয়ালাইজেশনের ধরন (Segel & Heer)
Stanford-এর Edward Segel ও Jeffrey Heer-এর ক্লাসিক গবেষণা “Narrative Visualization: Telling Stories with Data” (2010) সংবাদমাধ্যম থেকে গবেষণা পর্যন্ত কেস স্টাডি দেখে ন্যারেটিভ ভিজ্যুয়ালাইজেশনের স্বতন্ত্র genre চিহ্নিত করেছে, এবং একটা কাঠামো দিয়েছে যা author-driven (লেখকের চাপিয়ে দেওয়া ক্রম) বনাম reader-driven (পাঠকের নিজের অন্বেষণ) ভারসাম্য বুঝতে সাহায্য করে।
Wilke-র স্ট্যাটিক ফিগারের গল্প মূলত author-driven। ইন্টারেক্টিভ ড্যাশবোর্ড বা স্ক্রলিটেলিং বানালে এই কাঠামোটা কাজে লাগবে।
৯.৫ প্রমাণ: ডেটা স্টোরিটেলিং কি সত্যিই কাজ করে?
দীর্ঘদিন এই ক্ষেত্রে অভিজ্ঞতাভিত্তিক প্রমাণ কম ছিল। ২০২৪ সালের একটি CHI গবেষণায় (Monash University, ১০৩ জন অংশগ্রহণকারী) দেখা গেছে - প্রচলিত ভিজ্যুয়ালাইজেশনের তুলনায় ডেটা স্টোরি বোধগম্যতার কাজগুলোতে দক্ষতা (efficiency) বাড়ায়, এবং একক অন্তর্দৃষ্টিভিত্তিক কাজে কার্যকারিতাও (effectiveness) বাড়ায়।
কৌতূহলোদ্দীপক ফলাফল: এই সুবিধা অংশগ্রহণকারীদের ভিজ্যুয়ালাইজেশন-সাক্ষরতার সঙ্গে যুক্ত ছিল না - অর্থাৎ “স্টোরিটেলিং কেবল নতুনদের জন্য” এই ধারণাটা টেকে না।
| 📄 arXiv:2402.12634 | ACM DL |
৯.৬ সতর্কতা: গল্প পক্ষপাতও তৈরি করতে পারে
শেষ কথাটা জরুরি। স্টোরিটেলিং তথ্যকে “মানবিক” করে তোলে ঠিকই, কিন্তু গবেষকরা মনে করিয়ে দেন যে এর পক্ষপাতদুষ্ট দৃষ্টিভঙ্গি তৈরির সম্ভাবনা প্রায়ই উপেক্ষিত হয়, এবং ন্যারেটিভ ও আবেগ কখনো কখনো ভিজ্যুয়ালাইজেশনের সঠিক বোধগম্যতায় বাধা দিতে পারে (systematic review)।
Wilke-র “তথ্য ও যুক্তি দিয়ে গল্প বলুন” আর যেটাকে তিনি নিজেই প্রত্যাখ্যান করেন - সেই “overselling”-এর মধ্যে সীমারেখাটা বাস্তব, কিন্তু সেটা নিজে নিজে বজায় থাকে না। কয়েকটা আত্ম-পরীক্ষা:
- আমি কি এমন ডাইমেনশন বাদ দিয়েছি যা আমার উপসংহারকে দুর্বল করত? (গল্পের জন্য বাদ দেওয়া ≠ অসুবিধাজনক বলে বাদ দেওয়া)
- অক্ষের রেঞ্জ কি পার্থক্য বাড়িয়ে দেখানোর জন্য কাটা হয়েছে?
- আমার শিরোনামের উপসংহারটা ডেটা থেকেই আসছে, নাকি আমি চাই বলে?
- অনিশ্চয়তা (error bar, confidence interval, নমুনার আকার) কি দেখানো হয়েছে?
১০. ব্যবহারিক চেকলিস্ট
পরের বার রিপোর্ট বা প্রেজেন্টেশন বানানোর সময়:
- এক বাক্যে আমার মূল বক্তব্য কী? লিখে ফেলুন।
- দর্শক কারা, আর তাঁদের কাছে আমি কী চাই?
- আমার গল্পের আর্ক কী - টেনশন কোথায়, রেজলিউশন কোথায়?
- কোন ফিগার চ্যালেঞ্জ তৈরি করবে, কোনটা সমাধান দেবে?
- প্রতিটি ফিগার থেকে গল্পের সঙ্গে সম্পর্কহীন ডাইমেনশন বাদ দিয়েছি?
- জটিল ফিগারের আগে সরল সংস্করণ দেখিয়েছি?
- ফিগারগুলো কি একই ভিজ্যুয়াল ভাষায়, অথচ পরস্পর থেকে আলাদা দেখতে?
- প্রথম ফিগারটা কি কাঁচা ডেটার কাছাকাছি? Derived পরিমাণ কি পরে এসেছে?
- শিরোনামে উপসংহার আছে, নাকি শুধু বিষয়?
- অনিশ্চয়তা দেখানো হয়েছে?
- মাধ্যম অনুযায়ী ফিগারের সংখ্যা ঠিক আছে?
- “চোখ বন্ধ করে খুলুন” পরীক্ষায় প্রথম দুই সেকেন্ডে চোখ কি সঠিক জায়গায় পড়ে?
উপসংহার
ডেটা ভিজ্যুয়ালাইজেশনের সবচেয়ে কঠিন অংশ টুল শেখা নয়, বরং কী বাদ দিতে হবে সেটা ঠিক করা। একটা ফিগার তখনই সফল যখন সেটা:
- একটা স্পষ্ট পয়েন্ট বানায়,
- একটা বড় গল্পের নির্দিষ্ট জায়গায় বসে,
- ব্যস্ত মানুষ এক নজরে বুঝতে পারেন, এবং
- মনে থেকে যায়।
আপনার ডেটাতে গল্প আছে। প্রশ্ন হলো - সেটা আপনি বলবেন, নাকি দর্শককে বানিয়ে নিতে দেবেন।
সূত্র ও রেফারেন্স
মূল উৎস
- Claus O. Wilke, “Telling a story and making a point”, Fundamentals of Data Visualization, Chapter 29 - https://clauswilke.com/dataviz/telling-a-story.html
- সম্পূর্ণ বই (অনলাইনে বিনামূল্যে) - https://clauswilke.com/dataviz/
- বইয়ের সোর্স কোড (R Markdown + ggplot2) - https://github.com/clauswilke/dataviz
- মুদ্রিত সংস্করণ (O’Reilly, 2019, ISBN 978-1-492-03108-6) - https://www.oreilly.com/library/view/fundamentals-of-data/9781492031079/
বই ও ব্যবহারিক গাইড
- Cole Nussbaumer Knaflic, Storytelling with Data - https://www.storytellingwithdata.com
- Joshua Schimel, Writing Science (২৯ অধ্যায়ে Wilke-র সুপারিশকৃত)
- “6 key lessons on Data Storytelling” (Knaflic-এর সাক্ষাৎকার) - https://www.mauriziolacava.com/en/6-key-lessons-on-data-storytelling/
গবেষণাপত্র
-
Segel, E. & Heer, J. (2010). Narrative Visualization: Telling Stories with Data. IEEE TVCG 16(6), 1139–1148. DOI: 10.1109/TVCG.2010.179 Stanford Vis Group -
Shao, H., Martinez-Maldonado, R., Echeverria, V., Yan, L. & Gašević, D. (2024). Data Storytelling in Data Visualisation: Does it Enhance the Efficiency and Effectiveness of Information Retrieval and Insights Comprehension? CHI 2024. arXiv:2402.12634 DOI: 10.1145/3613904.3643022 - A Qualitative Analysis of Common Practices in Annotations: A Taxonomy and Design Space - arXiv:2306.06043
- A Survey on Annotations in Information Visualization: Empirical Insights, Applications, and Challenges - arXiv:2410.05579
- Bateman, S. et al. (2010). Useful Junk? The Effects of Visual Embellishment on Comprehension and Memorability of Charts. CHI 2010 - https://dl.acm.org/doi/10.1145/1753326.1753716
- Haroz, S., Kosara, R. & Franconeri, S. (2015). ISOTYPE Visualization: Working Memory, Performance, and Engagement with Pictographs. CHI 2015 - https://dl.acm.org/doi/10.1145/2702123.2702275
- Borgo, R. et al. (2012). Visual Embellishment: Cognitive Impact. IEEE TVCG - https://ieeexplore.ieee.org/document/6327266
- Re-understanding of data storytelling tools from a narrative perspective. Visual Intelligence (2023) - https://link.springer.com/article/10.1007/s44267-023-00011-0
ডেটা উৎস (Wilke-র উদাহরণগুলোর)
- প্রিপ্রিন্ট ডেটা: Jordan Anaya, PrePubMed - http://www.prepubmed.org/
- ফ্লাইট ডেটা: U.S. Dept. of Transportation, Bureau of Transportation Statistics - https://www.bts.gov/
- পোষা প্রাণীর ডেটা: 2012 U.S. Pet Ownership & Demographics Sourcebook, American Veterinary Medical Association - https://www.avma.org/
-
প্রিপ্রিন্ট সার্ভার: arXiv.org bioRxiv
Leave a comment